

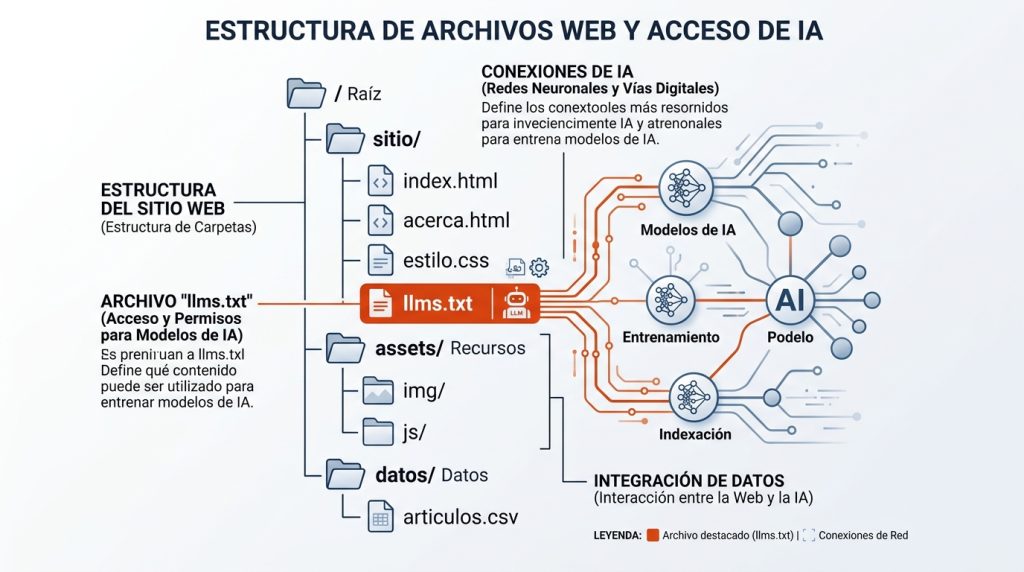

Si llevas tiempo trabajando en SEO o en visibilidad digital, ya sabes que las reglas del juego cambian con frecuencia. Pero lo que está ocurriendo ahora es diferente: los modelos de inteligencia artificial —ChatGPT, Perplexity, Gemini, Claude— se han convertido en una nueva puerta de entrada al conocimiento, y tu sitio web puede no estar preparado para hablar con ellos. El archivo llms.txt nació precisamente para resolver ese problema.
Contenidos
¿Qué es llms.txt exactamente?
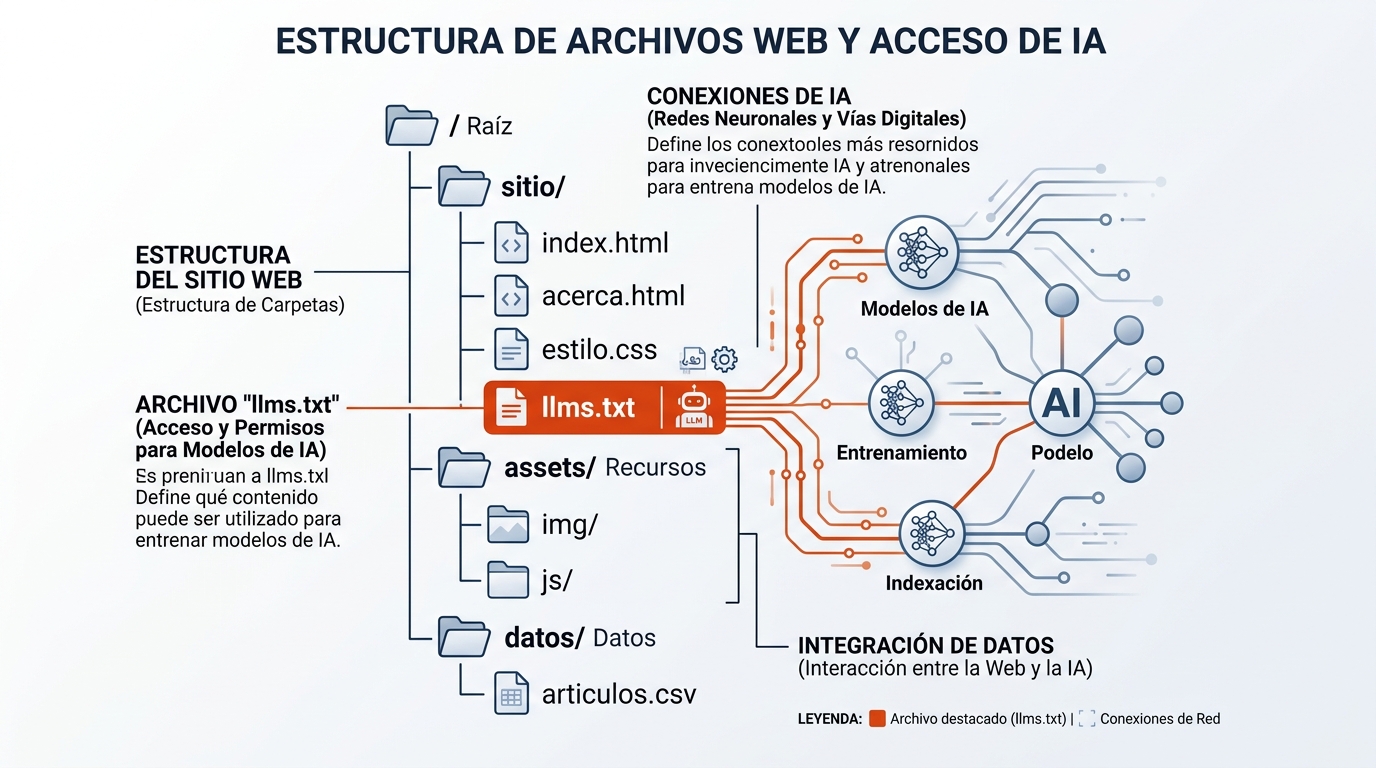
llms.txt es un archivo de texto plano en formato Markdown que se publica en la raíz de tu dominio —en la dirección https://tudominio.com/llms.txt— y proporciona a los grandes modelos de lenguaje (LLMs) un resumen estructurado y curado de las páginas más importantes de tu sitio. Piénsalo como un índice editorial escrito específicamente para que las IAs lo entiendan de un vistazo.
La idea central es simple: cuando un usuario le pregunta a ChatGPT o a Perplexity sobre un tema en el que tú eres referente, el modelo necesita entender qué eres, qué ofreces y dónde está tu contenido más valioso. El HTML de una web típica está lleno de menús, anuncios, scripts y código que dificultan esa lectura. El llms.txt elimina ese ruido y entrega la señal limpia.
El fichero incluye, como mínimo, un título (H1) con el nombre del sitio o proyecto. De forma opcional —y recomendable— añade un párrafo de descripción en formato blockquote y secciones H2 con enlaces a las páginas clave organizadas por categoría. Cuanto más claro y curado sea el fichero, mejor trabaja la IA con él.
¿Quién creó llms.txt y cuándo surgió este estándar?
Jeremy Howard, cofundador de Answer.AI, publicó la propuesta en septiembre de 2024. La especificación publicada vive en llmstxt.org. El punto de partida fue una observación muy concreta: los modelos de lenguaje tienen ventanas de contexto limitadas comparadas con la extensión de un sitio web completo, y obligarles a rastrear cientos de páginas HTML para responder una pregunta es ineficiente y genera pérdidas de información.
El estándar fue propuesto por Jeremy Howard de Answer.AI en septiembre de 2024, y en los meses siguientes ha ido ganando tracción dentro de lo que ahora se denomina Generative Engine Optimization, o GEO: la práctica de conseguir que tu sitio sea citado por ChatGPT, Claude, Perplexity, Gemini y otros grandes modelos de lenguaje que han empezado a complementar al buscador tradicional.
Es importante matizar que llms.txt no es un estándar oficial ratificado por el W3C o el IETF. Jeremy Howard y Answer.AI propusieron llms.txt en septiembre de 2024, y sigue siendo una convención comunitaria más que un estándar ratificado. La especificación es de código abierto en GitHub, así que trátala como una convención de bajo riesgo que vale la pena seguir, no como un requisito garantizado. Eso no le resta utilidad práctica: su adopción crece rápidamente y muchas herramientas de IA ya lo leen activamente.
¿Qué problema resuelve el archivo llms.txt?
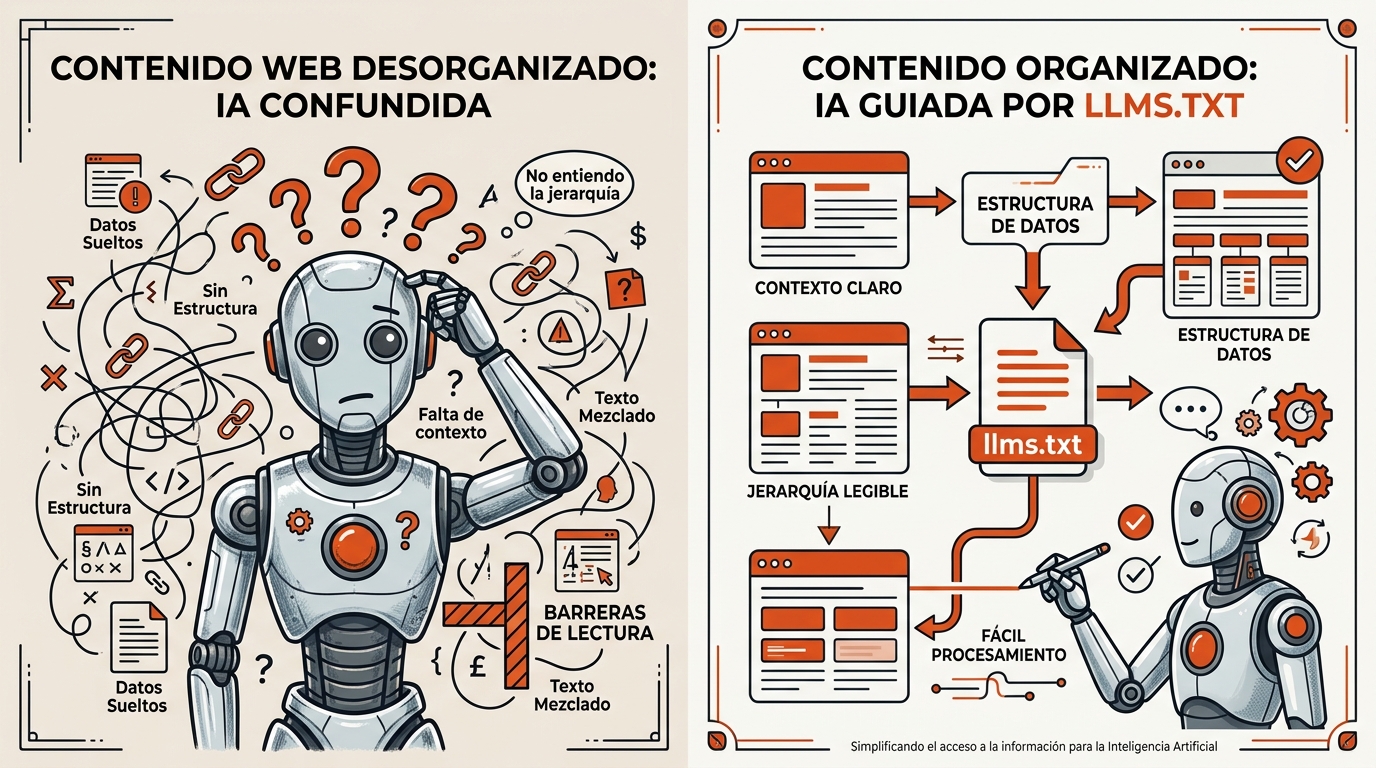
Los modelos de lenguaje no leen la web como lo hace un navegador. Cuando una IA necesita entender tu sitio, se enfrenta a un HTML cargado de etiquetas, scripts, estructuras de navegación y contenido irrelevante que dificulta extraer lo que realmente importa. El resultado es que la IA puede malinterpretar tu negocio, ignorar tu contenido más valioso o simplemente no citarte cuando debería.
El argumento original de Howard fue que los grandes modelos de lenguaje tienen ventanas de contexto pequeñas comparadas con un sitio web típico. Pedirle a un modelo que rastree un sitio entero cada vez que alguien quiere hacer una pregunta sobre tu producto es ineficiente y genera pérdidas.
El llms.txt resuelve esto con un enfoque de curation over coverage: en lugar de exponer todo, seleccionas lo más relevante y lo presentas en un formato que las IAs pueden procesar directamente. Un LLM puede cargar el contexto relevante del sitio en su ventana de contexto con una sola solicitud, sin necesidad de recuperar cada página por separado. Eso reduce errores de interpretación y aumenta las probabilidades de que el modelo te cite correctamente.
Además del llms.txt compacto, la especificación contempla un segundo fichero: llms-full.txt. Junto a la lista de enlaces curados, la especificación recomienda un segundo archivo: /llms-full.txt, que contiene el texto completo de todas las páginas referenciadas desde llms.txt, concatenadas de forma ordenada. Para sitios de documentación técnica o con contenido muy denso, esta versión extendida es especialmente útil.
¿En qué se diferencia llms.txt de robots.txt y de sitemap.xml?
Esta es la pregunta que más confusión genera, y vale la pena responderla con claridad. Los tres ficheros conviven en tu servidor y cada uno habla con un tipo distinto de «lector máquina», pero sus propósitos son completamente diferentes.
Ver los datos
| robots.txt | sitemap.xml | llms.txt | |
|---|---|---|---|
| ¿Qué hace? | Controla el acceso de rastreadores | Lista URLs indexables | Presenta contenido curado para IA |
| Propósito principal | Exclusión | Descubrimiento | Curaduría |
| ¿Bloquea contenido? | sí | no | no |
| ¿Lista todo el sitio? | no | sí | no |
| ¿Actúa en rastreo o inferencia? | Rastreo | Rastreo | Inferencia |
| Lector objetivo | Bots rastreadores | Motores de búsqueda | Modelos de lenguaje (IA) |
robots.txt: la valla de acceso
robots.txt controla quién tiene permitido rastrear tu sitio. Es un mecanismo de exclusión: le dice a los bots qué páginas no deben visitar. No describe tu contenido, no lo organiza ni lo prioriza. Es una valla, no un mapa. Si bloqueas un bot en robots.txt, ese bot no debería acceder a esas URLs independientemente de lo que diga tu llms.txt.
sitemap.xml: el directorio completo
sitemap.xml le dice a los rastreadores de búsqueda qué merece la pena rastrear. Su objetivo es la exhaustividad: listar todas las URLs indexables para que los motores de búsqueda las descubran. Un sitemap bien configurado puede tener miles de entradas; un llms.txt bien hecho debería tener decenas, no miles.
llms.txt: la curaduría para IA
robots.txt es sobre exclusión. sitemap.xml es sobre descubrimiento. llms.txt es sobre curaduría. No bloquea nada, no lista todo: selecciona lo mejor y lo presenta en el momento en que la IA está generando una respuesta, no cuando está rastreando para indexar.
El estándar toma su convención de ruta de archivo de robots.txt y sitemap.xml, pero sirve en un momento diferente. robots.txt controla a qué pueden acceder los rastreadores, y sitemap.xml lista cada página indexable para los motores de búsqueda. Ambos funcionan en tiempo de rastreo. llms.txt funciona en tiempo de inferencia, cuando un usuario le pregunta activamente a un asistente sobre tu contenido.
| Fichero | Propósito | Audiencia | Enfoque |
|---|---|---|---|
| robots.txt | Controla el acceso de rastreadores | Bots de rastreo (Googlebot, GPTBot…) | Exclusión |
| sitemap.xml | Descubrimiento de URLs para buscadores | Motores de búsqueda | Exhaustividad |
| llms.txt | Mapa curado para modelos de IA | Agentes de IA y LLMs | Curaduría |
¿Qué información debe contener un buen llms.txt?
Un fichero llms.txt bien construido no es simplemente una lista de URLs. Es una presentación estratégica de tu negocio pensada para que una IA la entienda y la use correctamente cuando alguien le haga una pregunta relacionada con tu sector o tus servicios.
En Amara, ingeniería de marketing, cuando construimos o auditamos un llms.txt para un cliente, nos aseguramos de que el fichero recoja varios tipos de información que no siempre están disponibles de forma estructurada en otras partes de la web:
- Información propia del negocio: quién es la empresa, a qué se dedica y cuál es su propuesta de valor diferencial.
- Definición del target: a qué tipo de cliente va dirigido, qué problemas resuelve y en qué contexto.
- Servicios o productos principales: descritos de forma clara, sin jerga de marketing, para que la IA pueda asociarlos a las preguntas correctas.
- Áreas de conocimiento: los temas sobre los que el sitio es autoridad, que orientan a la IA sobre cuándo citarte como fuente fiable.
- Enlaces a contenido clave: organizados por secciones temáticas, priorizando las páginas más completas y actualizadas.
Esta información, bien organizada en Markdown, convierte tu llms.txt en una tarjeta de presentación que las IAs pueden leer, procesar y usar para responderte correctamente a ti y a tus potenciales clientes.
¿Tiene impacto real el llms.txt en el SEO y en la visibilidad por IA?
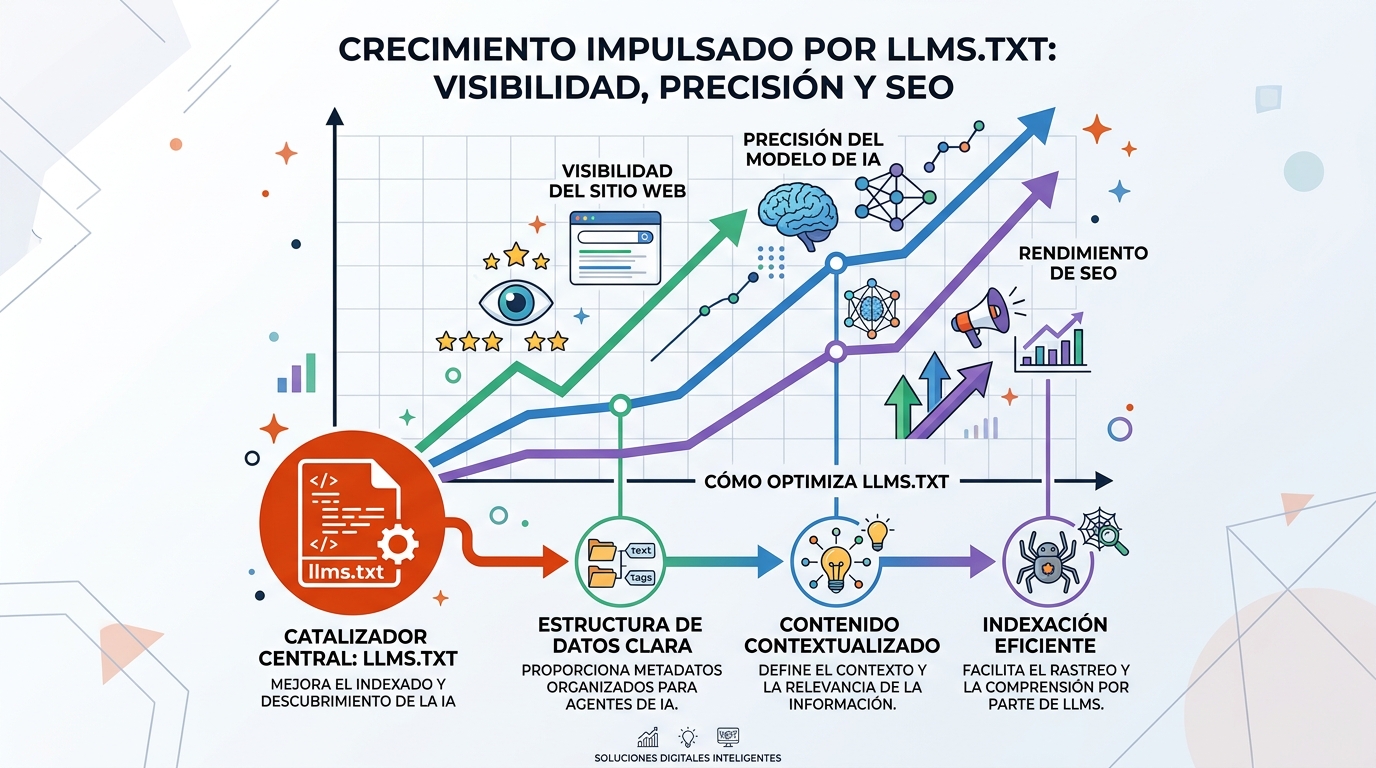
Esta es la pregunta del millón, y merece una respuesta honesta. El llms.txt no es un factor de ranking en Google y ningún proveedor de IA ha confirmado públicamente que lo use como señal obligatoria. Los principales proveedores de búsqueda no han confirmado que sea un input de ranking, y Google afirma que sus AI Overviews y AI Mode no requieren ningún fichero especial de IA.
Sin embargo, hay una distinción importante que no debes pasar por alto: el llms.txt no actúa en tiempo de rastreo, sino en tiempo de inferencia. Cuando un usuario le pregunta a un asistente de IA sobre tu sector y ese asistente tiene acceso a herramientas de búsqueda en tiempo real, el llms.txt puede ser exactamente lo que necesita para entenderte bien y citarte correctamente.
La adopción es voluntaria y desigual. Algunos productos de IA usan llms.txt como fuente primaria; otros lo ignoran por completo. Pero el coste de crearlo es mínimo y el potencial de beneficio, especialmente a medida que crece el ecosistema de agentes de IA, es real. En Amara, ingeniería de marketing, lo vemos como una inversión de bajo riesgo y alto potencial estratégico.
Además, tener un llms.txt bien estructurado es una señal de madurez digital. Indica que tu organización entiende cómo funciona el nuevo ecosistema de búsqueda y se posiciona proactivamente en él. Eso tiene valor reputacional más allá del tráfico directo.
¿Cuánto tiempo lleva crear y mantener un llms.txt?
Una de las barreras que más frena la adopción es la percepción de que crear un llms.txt es una tarea técnica compleja. En la práctica, con la herramienta adecuada el proceso es sorprendentemente rápido.
En Amara, ingeniería de marketing, utilizamos getllmsready.com para generar y mantener al día el llms.txt de nuestro sitio. La herramienta no solo genera el fichero en su versión compacta y en su versión extendida (llms-full.txt): también interpreta correctamente los contenidos del sitio, organiza la información para ofrecer las señales adecuadas a las IAs y, además, informa de las lecturas del fichero y del número de visitas a través de las IAs. Eso convierte el llms.txt en algo medible, no solo en una apuesta a ciegas.
De hecho, getllmsready.com se creó precisamente para cubrir esa necesidad: disponer de una herramienta que generara tanto la versión compacta como la extendida, que interpretara correctamente los contenidos del sitio web y que organizara la información para ofrecer las señales adecuadas a las IAs. El resultado es un fichero que no solo cumple la especificación técnica, sino que está optimizado para ser útil en el momento de la inferencia.
El mantenimiento también es sencillo. El llms.txt debe actualizarse siempre que añadas páginas, cambies precios o actualices características relevantes. Con una herramienta automatizada, ese proceso es prácticamente transparente.
¿Por qué deberías implementar llms.txt en tu sitio web ahora mismo?
La ventana de oportunidad para diferenciarse en el ecosistema de IA todavía está abierta. La mayoría de sitios web —incluidos muchos de tus competidores— aún no tienen un llms.txt, lo que significa que las IAs que intentan entender su sector están trabajando con información incompleta, mal estructurada o directamente ausente.
Implementar llms.txt hoy tiene varias ventajas concretas:
- Controlas la narrativa: decides qué información recibe la IA sobre tu negocio, en lugar de dejar que lo infiera del HTML de tu web.
- Mejoras las posibilidades de ser citado: cuando un agente de IA tiene acceso a tu llms.txt, puede responderte con precisión y atribuirte correctamente.
- Preparas tu web para el futuro: el ecosistema de agentes de IA crece rápido; cuanto antes estés presente en él, antes acumulas señales de autoridad.
- Coste de implementación mínimo: con herramientas como getllmsready.com, el tiempo de puesta en marcha se mide en minutos, no en días.
- Complementa tu estrategia SEO existente: no sustituye nada de lo que ya haces; añade una capa de visibilidad en un canal nuevo.
En Amara, ingeniería de marketing, llevamos tiempo trabajando en la intersección entre SEO tradicional y optimización para IA. Nuestra experiencia directa nos confirma que construir un fichero llms.txt es sencillo con la herramienta adecuada y aporta una cantidad significativa de información estructurada a los modelos de lenguaje, información que de otro modo tendrían que inferir —con menor precisión— del contenido HTML de tu sitio.
Fuentes
- Large Model Based Agents: State-of-the-Art, Cooperation Paradigms, Security and Privacy, and Future Trends
- llms.txt vs robots.txt vs sitemap.xml — What’s the Difference?
- What is llms.txt? How the New AI Standard Works (2026 Guide)
- llms.txt: The Complete 2026 Guide (Generator, Examples, Validators) – LLM Pulse
- llms.txt: Proposed Standard for LLM Content · Murat Ulusoy