

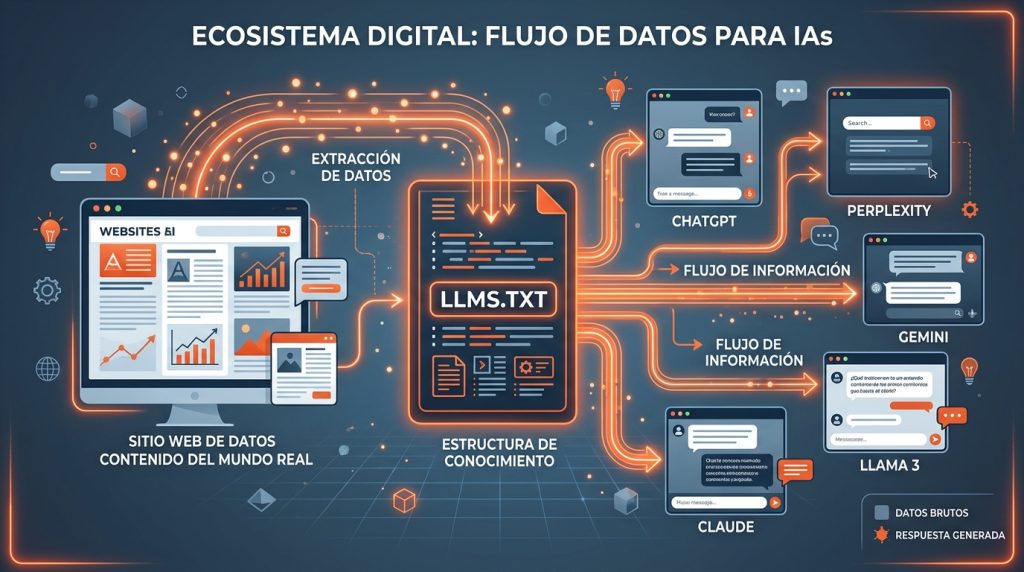

¿Tiene sentido publicar un archivo llms.txt si lo que buscas es que ChatGPT, Perplexity u otros modelos de lenguaje mencionen tu marca? Es la pregunta que más nos hacen en Amara, ingeniería de marketing desde que empezamos a trabajar este estándar con nuestros clientes. La respuesta honesta es: depende de lo que entiendas por «visibilidad en IA» y de las expectativas que pongas en ese archivo. En este artículo te explicamos qué hace realmente llms.txt, qué evidencias hay de su impacto en la visibilidad de tu marca ante los modelos y dónde encaja dentro de una estrategia de posicionamiento en motores de respuesta.
Contenidos
¿Qué es llms.txt y por qué le importa a los modelos de IA?
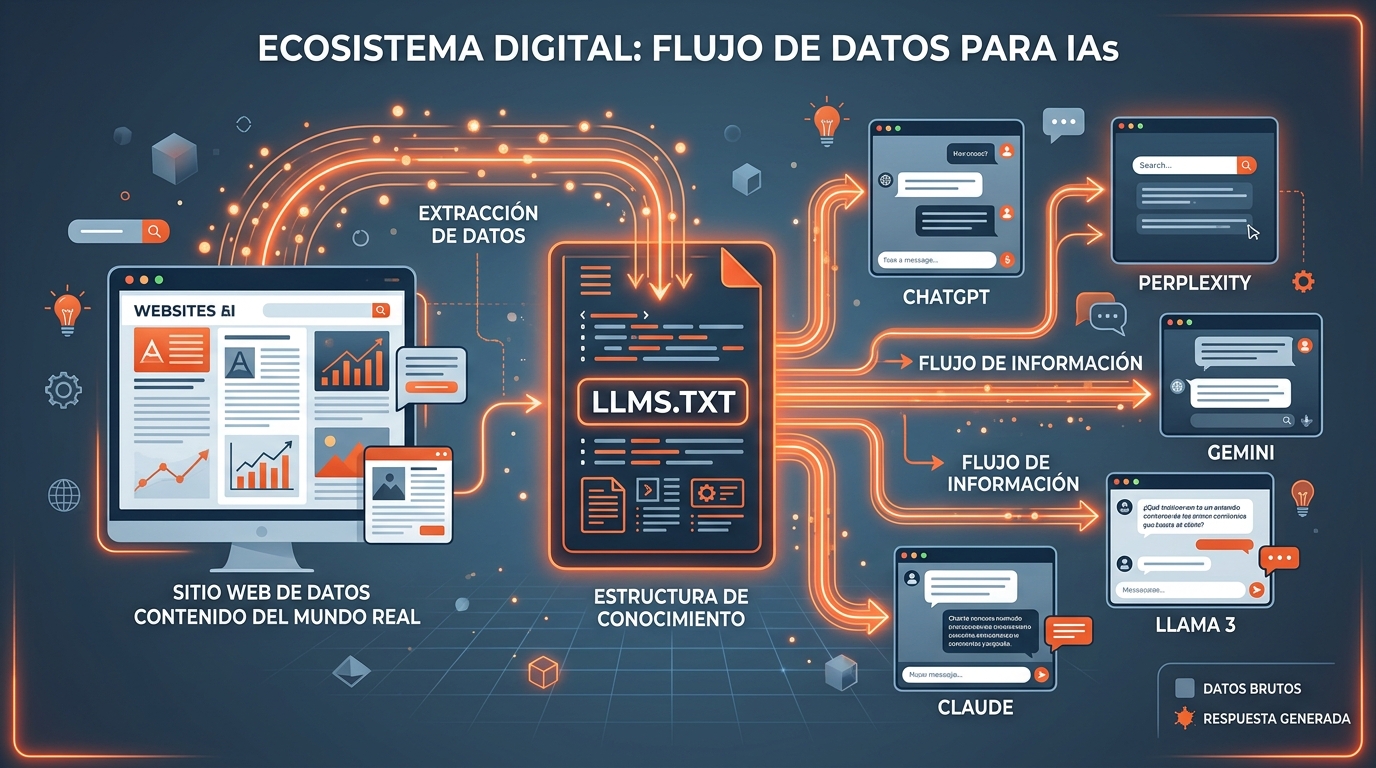
llms.txt es un archivo de texto legible por máquinas que proporciona a los LLMs —como ChatGPT o Claude— contexto sobre tu sitio web. Su formato es Markdown y vive en la raíz del dominio, igual que robots.txt. La diferencia fundamental es que robots.txt controla el acceso de los rastreadores, mientras que llms.txt guía a los que ya tienen acceso hacia tu contenido prioritario.
El problema que resuelve es concreto: tu sitio puede estar en la primera posición de Google y seguir siendo prácticamente invisible para sistemas de IA como ChatGPT, Perplexity o Claude, porque los modelos de lenguaje no interpretan los sitios web igual que Google. Acceden al contenido bajo demanda, operan con ventanas de contexto limitadas y tienen dificultades con páginas que dependen mucho de JavaScript. Un archivo llms.txt bien estructurado actúa como un índice claro y legible que les dice dónde está lo importante.
La especificación oficial, propuesta por Jeremy Howard de Answer.AI en septiembre de 2024, define un formato intencionalmente minimalista: un H1 con el nombre del sitio, un bloque de descripción opcional y secciones H2 con enlaces anotados hacia las páginas más relevantes. Solo el H1 es obligatorio; todo lo demás es opcional pero recomendado.
En Amara, ingeniería de marketing lo vemos como un puente entre la arquitectura de tu web y la lógica de comprensión de los modelos: no reemplaza el contenido de calidad, pero sí elimina fricciones innecesarias para que ese contenido llegue a donde tiene que llegar.
Estructura mínima de un llms.txt real
Antes de hablar de impacto, conviene ver de qué estamos hablando exactamente. Este es el esqueleto canónico de un archivo llms.txt bien formado, siguiendo la especificación publicada en llmstxt.org:
# Nombre del sitio o proyecto
> Descripción breve en una o dos frases: qué hace este sitio y a quién va dirigido.
Contexto adicional en prosa libre (opcional): sector, propuesta de valor, idioma principal.
## Contenido principal
– [Qué es el AEO y cómo funciona](https://ejemplo.com/aeo/): Guía introductoria sobre Answer Engine Optimization.
– [Cómo implementar llms.txt paso a paso](https://ejemplo.com/llms-txt/): Tutorial técnico con ejemplos reales.
– [Estrategia de contenido para IA](https://ejemplo.com/contenido-ia/): Marco para crear contenido citable por modelos generativos.
## Sobre nosotros
– [Quiénes somos](https://ejemplo.com/sobre-nosotros/): Equipo, misión y enfoque de trabajo.
– [Casos de éxito](https://ejemplo.com/casos/): Resultados reales con clientes.
## Opcional
– [Glosario de términos AEO](https://ejemplo.com/glosario/): Definiciones de RAG, GEO, AEO y otros conceptos clave.
Algunas reglas que conviene recordar: no se permiten imágenes, tablas ni bloques de código dentro del archivo; los parsers esperan solo texto Markdown y listas de enlaces. Cuanto más limpio y predecible sea el formato, más fiablemente lo procesarán los sistemas que sí lo leen. La sección «Opcional» sirve para recursos secundarios que un agente puede omitir si su ventana de contexto es limitada.
llms.txt, robots.txt y sitemap.xml: cómo se complementan
Los tres archivos conviven en la raíz de tu dominio y se dirigen a audiencias distintas dentro del ecosistema de rastreo:
| Archivo | Función principal | Formato | Destinatario |
|---|---|---|---|
| robots.txt | Control de acceso: qué páginas pueden rastrear los bots | Texto plano con directivas | Todos los rastreadores web |
| sitemap.xml | Descubrimiento de URLs para indexación | XML estructurado | Rastreadores de buscadores |
| llms.txt | Curación de contenido prioritario para IA | Markdown legible | Agentes de IA en inferencia |
La lógica es aditiva: robots.txt decide quién entra, sitemap.xml muestra el mapa completo, y llms.txt señala lo más valioso para quien ya está dentro. Un error frecuente es tratar llms.txt como sustituto del sitemap; son complementarios. Y un error aún más grave —lo mencionamos más adelante— es tener llms.txt publicado mientras bloqueas los bots de IA en robots.txt.
¿Qué modelos leen realmente el archivo llms.txt?
Aquí conviene ser precisos, porque el marketing alrededor de este estándar ha generado más expectativas de las que los datos justifican. La adopción oficial por parte de los grandes proveedores de IA es, a día de hoy, limitada.
OpenAI y ChatGPT
No hay confirmación oficial de OpenAI sobre si GPTBot procesa llms.txt. Algunas observaciones en campo sugieren que el rastreador puede acceder al archivo cuando está presente, pero su influencia en cómo ChatGPT selecciona, ordena o cita el contenido no está documentada. Dicho de otro modo: que un bot visite el archivo no es lo mismo que confirmar que ese archivo influye en las respuestas que ve el usuario.
Perplexity
Perplexity es el nombre que con más frecuencia se asocia en la comunidad al uso de llms.txt para identificar fuentes autorizadas sobre un tema concreto. Aun así, tampoco existe documentación oficial de Perplexity que lo confirme de forma vinculante, por lo que conviene tomarlo como una señal observada en campo y no como una garantía de citación.
Anthropic y casos de adopción real
El caso más documentado es el de Anthropic: Anthropic recomienda llms.txt para la ingesta de documentación por parte de Claude, y compañías como Cloudflare y Vercel también lo han adoptado. Esto no significa que Claude lo lea en producción para todas las consultas, sino que el formato ha ganado tracción en ecosistemas de documentación técnica donde los agentes de IA acceden al contenido de forma programática.
El estado real de la adopción
Los datos de 2026 ofrecen una imagen clara y algo desconcertante. En junio de 2025 se contabilizaban 4.088 instancias de llms.txt; en mayo de 2026 esa cifra había alcanzado 36.120, un crecimiento de 8,8 veces en doce meses, según el estudio de seguimiento de Originality.ai sobre más de 3 millones de sitios web. A junio de 2026, el 8,7% de los 1.000 sitios web más visitados del mundo publica un archivo llms.txt, según el tracker mensual de Rankability.
Pero la adopción no se traduce en uso real. Un estudio de Ahrefs publicado en junio de 2026, basado en logs de servidor de 137.000 dominios, encontró que el 97% de los archivos llms.txt no recibió ninguna solicitud en mayo de 2026. Los principales solicitantes fueron herramientas de auditoría SEO con el 21,7% de las solicitudes, seguidas de bots no identificados con el 14,9%; los asistentes de IA para los que se diseñó el formato estaban prácticamente ausentes de los logs.
¿Qué evidencias reales hay sobre su impacto en la visibilidad de marca?
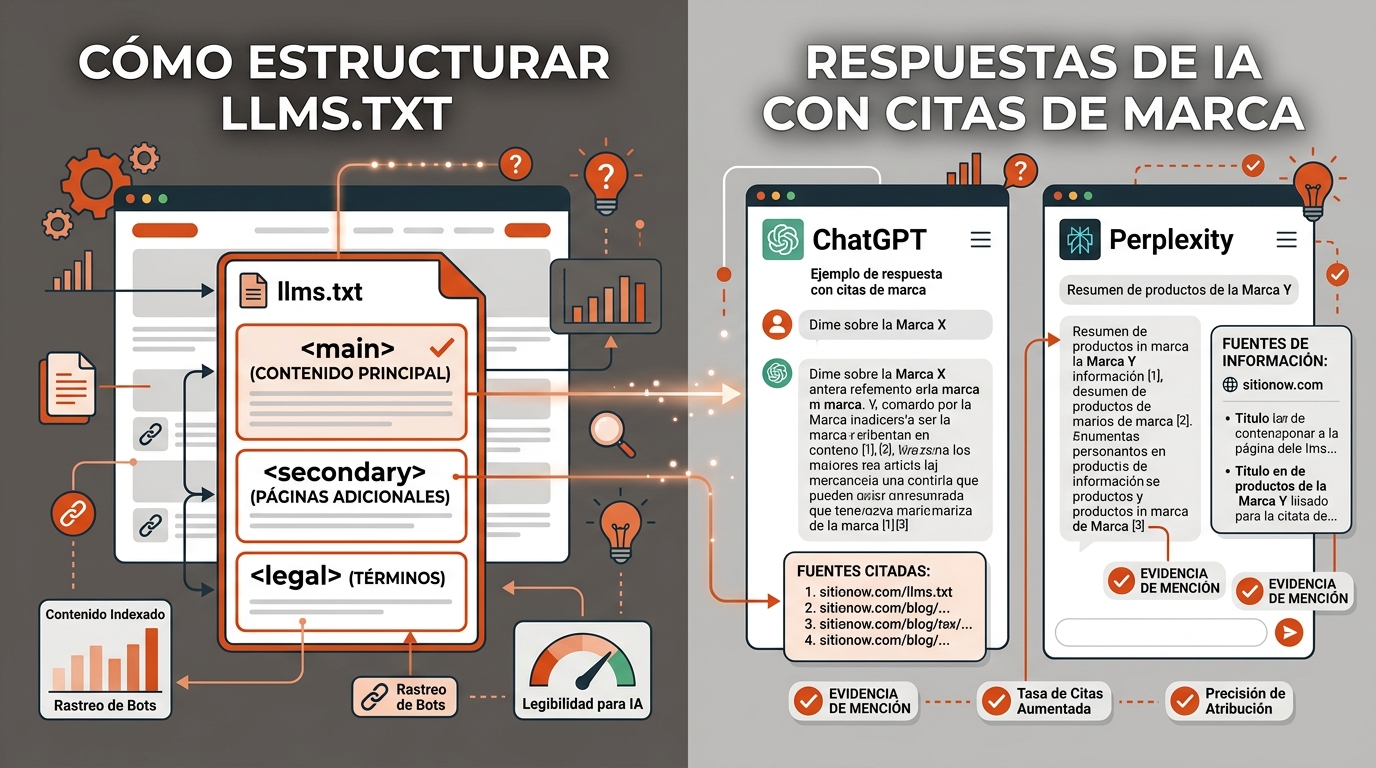
El debate en la comunidad SEO y de marketing digital es activo, y los datos disponibles apuntan en direcciones distintas según la fuente. Conviene conocer ambas caras.
Search Engine Land publicó en enero de 2026 un análisis de 10 sitios web rastreados durante 90 días antes y 90 días después de implementar llms.txt: dos sitios vieron incrementos de tráfico IA del 12,5% y el 25%, ocho no registraron mejora medible, y uno experimentó un descenso del 19,7%. Los resultados son heterogéneos y dificultan cualquier conclusión universal.
En el extremo más escéptico, el modelo XGBoost de SE Ranking encontró que eliminar la variable llms.txt mejoraba la precisión de predicción de citaciones, lo que sugiere que el archivo actualmente añade ruido en lugar de señal. ALLMO encontró llms.txt en solo 1 de cada 50 dominios altamente citados y observó apenas 1 citación directa de una página de llms.txt entre 94.614 URLs citadas.
En Amara, ingeniería de marketing, nuestra experiencia directa apunta a un efecto positivo: desde que publicamos nuestro propio llms.txt, hemos observado un incremento en el número de visitas que llegan a través de LLMs. No es un volumen masivo, pero la tendencia es clara y consistente dentro de nuestra propia operativa. La clave, en nuestra lectura, no es que el archivo sea la causa directa, sino que forma parte de un conjunto de señales técnicas que facilitan la comprensión del sitio por parte de los modelos.
AEO y GEO: el contexto estratégico donde llms.txt cobra sentido
Para entender el papel de llms.txt en la visibilidad de tu marca ante los modelos de IA, necesitas conocer dos conceptos que han ganado protagonismo en los últimos dos años: AEO (Answer Engine Optimization) y GEO (Generative Engine Optimization).
AEO es la práctica de optimizar tu presencia online para ser descubierto, comprendido y citado por modelos de IA como ChatGPT, Perplexity y Google AI Overviews. GEO va un paso más allá: se centra específicamente en cómo los motores generativos —aquellos que producen respuestas sintetizadas en lugar de listas de enlaces— seleccionan y atribuyen las fuentes que citan. llms.txt se ha convertido en la convención de facto para lo que ahora se llama GEO, la práctica de conseguir que tu sitio sea citado por ChatGPT, Claude, Perplexity, Gemini y otros grandes modelos de lenguaje que han empezado a reemplazar el buscador tradicional.
La diferencia con el SEO tradicional es sustancial: mientras el SEO mide el éxito por posición de ranking y clics, el AEO mide el éxito por menciones de marca y citaciones directas dentro de respuestas conversacionales. El objetivo ya no es solo aparecer en la primera página de Google; es que el modelo de IA te nombre cuando alguien le pregunta algo relevante para tu negocio. Conceptos como el zero-click —búsquedas que se resuelven sin que el usuario visite ningún sitio— y los AI Overviews de Google hacen que esta distinción sea cada vez más relevante para cualquier estrategia de contenido.
Dentro de esta estrategia, llms.txt ocupa un lugar técnico pero no central. Los sitios que aparecen con más frecuencia en las respuestas de ChatGPT, Perplexity y Claude son los que tienen bases sólidas de SEO tradicional, cobertura significativa de terceros y contenido escrito para responder las preguntas específicas de su audiencia. llms.txt apoya ese trabajo, pero no lo sustituye.
¿Qué factores determinan realmente que tu marca aparezca en respuestas IA?
Si llms.txt no es el factor decisivo, ¿qué lo es? La investigación disponible señala con bastante consistencia los mismos elementos.
- Menciones en fuentes de terceros: la presencia en listados de terceros, las menciones de marca en la web, la co-ocurrencia de marca y la presencia en Reddit y plataformas de reseñas son los principales factores que impulsan las recomendaciones de ChatGPT. Los modelos aprenden de lo que otros dicen de ti, no solo de lo que tú dices de ti mismo.
- Autoridad del dominio y backlinks: los modelos de IA aprenden de contenido que ya tiene peso en la web. Un dominio con autoridad consolidada tiene más probabilidades de ser citado porque los datos de entrenamiento y los sistemas RAG (Retrieval-Augmented Generation) priorizan fuentes que ya son relevantes para los buscadores tradicionales.
- Contenido estructurado para responder preguntas: la capacidad del motor para extraer una respuesta limpia de tu contenido depende de la estructura de la página: respuestas directas bajo encabezados, datos estructurados (schema markup), tablas comparativas y estadísticas con nombre. El structured data que ya usas para SEO también beneficia tu visibilidad en IA.
- Frescura del contenido: los LLMs favorecen el contenido reciente. Incluir el año en curso en títulos, meta descriptions y slugs puede aumentar la probabilidad de citación, especialmente en motores como Perplexity que hacen RAG en tiempo real.
- Accesibilidad técnica para rastreadores de IA: aquí es donde llms.txt sí aporta valor directo, especialmente en sitios con mucho JavaScript o arquitecturas complejas, mejorando de forma concreta la visibilidad ante los modelos de IA.
En Amara, ingeniería de marketing trabajamos todos estos frentes de forma integrada. El archivo llms.txt es uno de los primeros pasos que recomendamos porque su coste de implementación es prácticamente cero, pero siempre dentro de una estrategia más amplia de AEO.
¿Cuánto esfuerzo requiere implementar llms.txt correctamente?
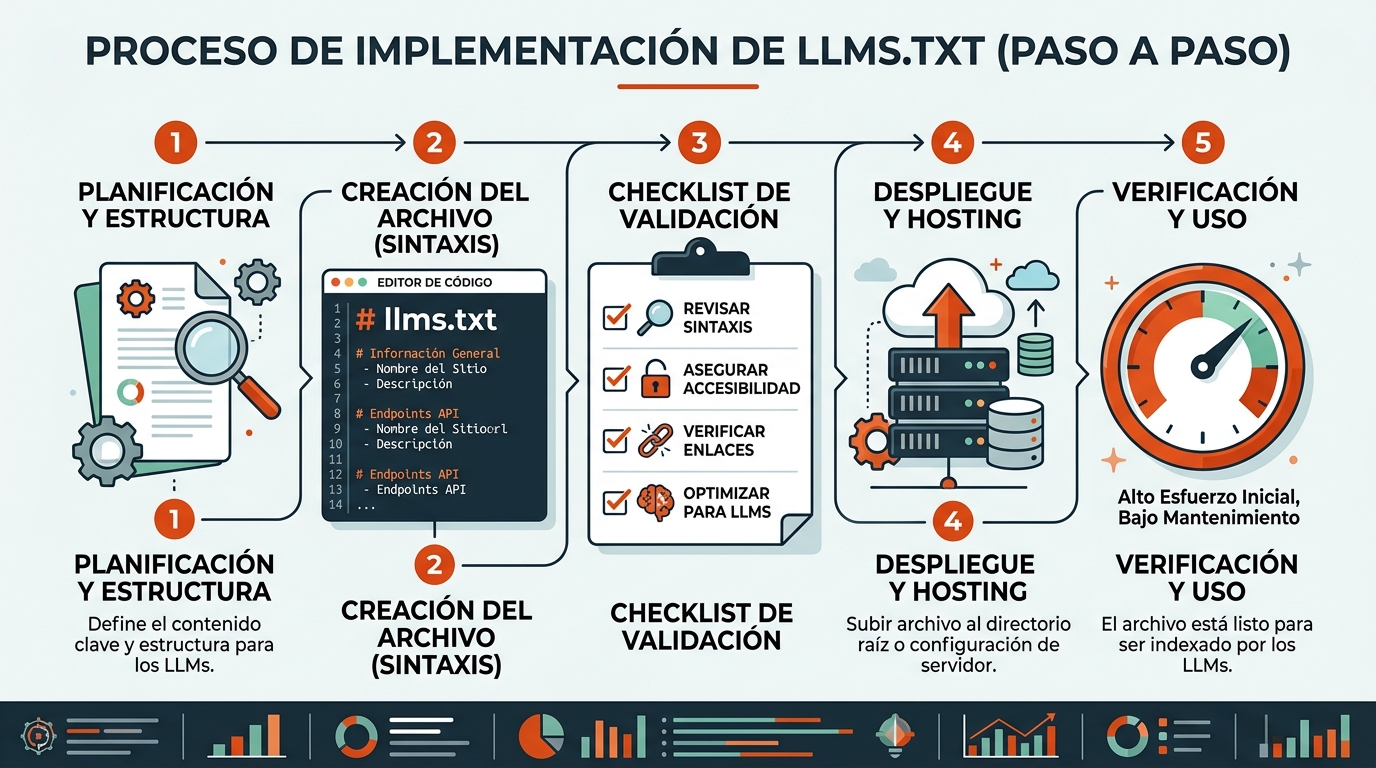
Una de las barreras que más frena a empresas y profesionales es la percepción de que crear y mantener un llms.txt bien hecho es un proceso técnico complejo. En la práctica, no tiene por qué serlo.
En Amara, ingeniería de marketing, cuando implementamos nuestro propio archivo, tardamos prácticamente nada: usamos getllmsready.com, un plugin que se ocupa de estudiar el sitio web, categorizar la información y generar el fichero de forma automática, sin esfuerzo manual. El resultado fue un archivo estructurado y actualizado que refleja fielmente la arquitectura de contenido del sitio.
El error más habitual que vemos en empresas que intentan implementar llms.txt sin éxito es precisamente el opuesto: generarlo a mano al 100%. El esfuerzo que requiere hacerlo bien —mapear el sitio, categorizar el contenido, mantenerlo actualizado— hace que muchos equipos lo abandonen a las pocas semanas de empezar. La automatización no es un atajo; es la diferencia entre tener un archivo útil y tener un archivo desactualizado que confunde más que ayuda.
Tras desplegar llms.txt, las primeras citaciones no suelen ser inmediatas: conviene dar al archivo varias semanas de margen antes de evaluar su impacto, y comunicarlo así a los equipos para gestionar expectativas internas.
¿Cómo medir si llms.txt está mejorando tu visibilidad de marca en IA?
Medir el impacto de llms.txt de forma aislada es complicado, porque los modelos de IA no publican datos de rastreo ni de citación. Sin embargo, sí puedes monitorizar la visibilidad de tu marca en motores de respuesta con las métricas adecuadas.
Métricas clave de AEO
El rendimiento en AEO suele medirse combinando varios KPIs: frecuencia de citación en respuestas de IA, tasa de mención de marca, cuota de voz entre motores de IA, cobertura temática y evolución de la tasa de zero-click. Estas métricas difieren fundamentalmente de las métricas tradicionales de ranking y clics del SEO.
Una distinción importante que señalan los expertos en AEO: muchas herramientas reportan «menciones de marca» en respuestas de IA sin distinguir entre aparecer en una lista de opciones (mención) y tener tu URL citada como fuente (citación). Una marca puede ganar menciones y perder citaciones al mismo tiempo, así que conviene asegurarse de que la herramienta que uses diferencia ambos conceptos.
Herramientas para rastrear tu presencia en respuestas IA
Herramientas como Semrush, Advanced Web Ranking y plataformas especializadas como Profound permiten rastrear dónde aparece tu marca en los motores de respuesta de IA. Monitorizan citaciones, menciones de marca y cuota de voz en ChatGPT, Perplexity, Gemini y otros.
En Amara, ingeniería de marketing combinamos el seguimiento de tráfico referido desde LLMs con auditorías periódicas de menciones en los principales motores de respuesta. No es un proceso complejo, pero sí requiere constancia: la visibilidad en IA fluctúa con cada actualización de los modelos y con los cambios en el contenido de terceros que te mencionan.
¿Qué expectativas son realistas para tu marca?
Esta es la pregunta que más importa y la que más se esquiva en la mayoría de los artículos sobre llms.txt. Vamos con datos concretos.
En cuanto a plazos: los sitios que han reportado mejoras en tráfico referido desde LLMs después de implementar llms.txt hablan de ventanas de entre 4 y 12 semanas antes de observar cambios consistentes. Esto no es exclusivo de llms.txt —cualquier cambio de señal técnica tarda en propagarse—, pero es importante comunicarlo internamente para no abandonar la iniciativa antes de tiempo.
En cuanto a volumen: el tráfico referido desde LLMs sigue siendo marginal para la mayoría de los sitios. Los estudios disponibles sugieren que incluso los sitios que ven mejoras hablan de incrementos en visitas desde fuentes como ChatGPT o Perplexity, no de volúmenes que rivalicen con el tráfico orgánico de Google. De los 10 sitios analizados por Search Engine Land, solo 2 vieron incrementos de tráfico IA del 12,5% y el 25% respectivamente tras implementar el archivo; los demás no registraron cambio medible. Eso significa que el escenario más probable, hoy, es que llms.txt no mueva el tráfico de forma directa y aislada.
¿Entonces para qué implementarlo? Porque el coste de oportunidad de no tenerlo es cero hoy, pero podría no serlo mañana. La analogía con robots.txt es útil: cuando ese archivo se popularizó, tampoco había garantía de que todos los bots lo respetaran. Hoy es una convención universal. llms.txt está en ese proceso de maduración, y los sitios que lo implementen bien ahora estarán mejor posicionados cuando los grandes proveedores decidan adoptarlo de forma oficial.
La recomendación práctica de Amara es esta: implementa llms.txt como parte de tu higiene técnica de AEO —no como tu apuesta principal—, mide el tráfico referido desde LLMs como línea base, y dedica la mayor parte de tu energía a los factores que sí tienen impacto demostrado: menciones en terceros, contenido estructurado para responder preguntas y autoridad de dominio.
Preguntas frecuentes
¿Llms.txt afecta al SEO tradicional de Google?
No de forma directa. Google ha confirmado que AI Overviews y AI Mode se basan en señales SEO tradicionales y no requieren ningún archivo de IA específico. llms.txt no es un factor de ranking en la búsqueda orgánica de Google. Su valor está en facilitar el acceso de agentes de IA y rastreadores especializados, no en influir en el algoritmo de PageRank.
¿Con qué frecuencia debo actualizar mi llms.txt?
La regla práctica es actualizarlo cada vez que publiques contenido nuevo relevante o cambies la arquitectura de información del sitio. Si usas una herramienta de generación automática como getllmsready.com, el archivo se mantiene sincronizado sin intervención manual. Un archivo desactualizado que apunta a páginas inexistentes o a contenido obsoleto es peor que no tener archivo: genera señales contradictorias para los sistemas que sí lo procesan.
¿Qué pasa si no tengo llms.txt publicado?
Nada catastrófico a corto plazo. La mayoría de los sitios sin llms.txt siguen siendo citados por modelos de IA si tienen buen contenido, autoridad de dominio y menciones en terceros. Lo que pierdes sin el archivo es la capacidad de guiar a los agentes de IA hacia tu contenido más valioso, especialmente en sitios con arquitecturas complejas o mucho JavaScript. Es una ventaja marginal hoy, pero puede ser más relevante a medida que los modelos maduren su soporte al estándar.
¿Es llms.txt un estándar oficial?
Todavía no en el sentido técnico estricto. Es una propuesta impulsada por la comunidad, originada por Jeremy Howard de Answer.AI en septiembre de 2024, y publicada en llmstxt.org. No forma parte de ningún RFC ni de los estándares del W3C, aunque la especificación alcanzó su versión 2 en agosto de 2026. Compañías como Anthropic, Cloudflare y Vercel lo han adoptado voluntariamente, lo que le da peso en el ecosistema técnico aunque no sea obligatorio.
¿Llms.txt funciona igual en todos los sectores?
No. El impacto es más claro en sectores donde los agentes de IA acceden a documentación técnica de forma programática: SaaS, herramientas para desarrolladores y plataformas de documentación. En e-commerce o medios de comunicación, donde el contenido es más dinámico y el volumen de páginas es mayor, el valor del archivo depende más de una buena curación de las páginas listadas que de la mera presencia del archivo. En servicios profesionales B2B, llms.txt puede ser especialmente útil para posicionar la propuesta de valor de forma clara ante agentes de investigación y comparación.