


Publicar un archivo llms.txt y olvidarse de él es, paradójicamente, uno de los errores llms.txt más extendidos. El fichero existe, el servidor lo sirve… pero los modelos de IA lo ignoran porque tiene la ruta mal, el Markdown roto o información que lleva meses sin actualizarse. Este artículo no explica qué es llms.txt ni por qué deberías tenerlo —eso lo cubrimos en el pilar del cluster—; aquí nos centramos en los fallos concretos que hacen que el archivo no funcione y en cómo detectarlos y corregirlos antes de que perjudiquen tu visibilidad en respuestas generativas.
Contenidos
¿Por qué tantos archivos llms.txt no funcionan en la práctica?
Revisando sitios con validadores de llms.txt, la conclusión es clara: la mayoría están rotos. No en el sentido de que el servidor devuelva un error 500, sino en el de que el archivo no cumple la especificación. El problema es que el fallo es silencioso: el navegador carga el fichero, tú ves texto, y todo parece correcto. Pero el parser del modelo de IA lo descarta sin avisar.
Conviene además tener presente el contexto real: según un análisis de más de 500 millones de eventos de tráfico de bots LLM publicado por Limy, los rastreadores como GPTBot, ClaudeBot y PerplexityBot casi nunca recuperan /llms.txt y rastrean el HTML directamente. Esto no significa que el archivo sea inútil —los agentes de IA y herramientas de inferencia sí lo consultan—, pero sí que un fichero mal configurado tiene aún menos margen de error del que parece. Para la visibilidad en respuestas generativas y en sistemas de Answer Engine Optimization, cada señal de contexto cuenta.
En Amara, ingeniería de marketing, cuando ayudamos a empresas a configurar su llms.txt, el patrón se repite: el archivo existe, pero tiene uno o varios de los fallos que detallamos a continuación. Conocer estos errores de antemano te ahorra semanas de visibilidad perdida.
¿Qué rastreadores de IA leen llms.txt (y cuáles no)?
Antes de corregir errores, conviene saber a quién le estás hablando. El panorama de rastreadores de IA en 2026 es más matizado de lo que parece, y no todos los bots se comportan igual ante tu archivo.
| Rastreador | Empresa | Propósito | ¿Lee llms.txt? | ¿Respeta robots.txt? |
|---|---|---|---|---|
| GPTBot | OpenAI | Entrenamiento de modelos | Ocasionalmente | Sí (documentado) |
| OAI-SearchBot | OpenAI | Índice de ChatGPT Search | No confirmado | Sí |
| ClaudeBot | Anthropic | Entrenamiento / rastreo | Ocasionalmente | Sí (documentado) |
| PerplexityBot | Perplexity | Búsqueda / respuestas | Ocasionalmente | Sí (documentado) |
| Googlebot / Google-Extended | Búsqueda tradicional / IA | No | Sí |
El dato más relevante para tu estrategia: Google no lee llms.txt y ha confirmado que no planea hacerlo. En julio de 2025, el representante de Search Relations de Google, Gary Illyes, comparó públicamente llms.txt con la etiqueta meta “keywords” desacreditada e indicó que ningún sistema de Google actúa sobre el archivo. Implementar llms.txt no mejora tu posicionamiento en Google Search ni en AI Overviews.
También es importante distinguir entre rastreadores de entrenamiento y rastreadores de búsqueda: puedes bloquear GPTBot (entrenamiento) mientras permites OAI-SearchBot (citas en ChatGPT Search), y lo mismo aplica para los pares equivalentes de Anthropic y Google. Esta distinción afecta directamente a cómo configuras tu robots.txt en relación con tu llms.txt.
Error 1: ¿Tu archivo está en la ruta correcta?
Muchos equipos crean el archivo pero no lo colocan correctamente. Si está en una subcarpeta —por ejemplo, /docs/llms.txt— o en un dominio de staging, los rastreadores de IA no lo encontrarán en la ubicación estándar. Este fallo de ruta es uno de los errores del fichero más fáciles de cometer y más fáciles de pasar por alto.
La solución es siempre la misma: aloja el archivo en el directorio raíz de tu dominio, en https://tudominio.com/llms.txt. Esa es la ubicación que los rastreadores de IA comprueban primero. Es el equivalente exacto a donde vive tu robots.txt: en la raíz, accesible sin autenticación, sin redirecciones.
Compruébalo abriendo la URL directamente en el navegador. Si no carga o redirige a otra página, tienes un problema de ruta que invalida el fichero por completo.
Error 2: ¿El servidor devuelve el tipo MIME correcto?
Este es uno de los fallos más invisibles y, al mismo tiempo, de los más dañinos. Tu servidor debe servir el archivo como text/plain o text/markdown con charset=utf-8. Un fallo habitual es que el servidor devuelva text/html porque trata el archivo como un 404 y sirve la página de inicio. En ese caso, el rastreador de IA recibe una página HTML completa en lugar de tu archivo Markdown limpio. Cuando esto ocurre, el llms.txt es técnicamente ilegible para el modelo aunque tú lo veas perfectamente en el navegador.
Los caracteres especiales no guardados en UTF-8 generan problemas de codificación que impiden la lectura correcta del archivo. La solución es guardar siempre el fichero como UTF-8 sin BOM y verificarlo con un validador.
Cómo comprobarlo: ejecuta curl -I tudominio.com/llms.txt en tu terminal y revisa la cabecera Content-Type. Debe mostrar text/plain; charset=utf-8 o similar. Si ves text/html, hay un problema de configuración en el servidor que hace que el fichero sea ilegible para los modelos.
Cómo corregir el tipo MIME según tu entorno
La corrección varía según el servidor o CMS que uses. Aquí tienes las instrucciones para los entornos más habituales:
- Apache (.htaccess): añade esta directiva en el archivo .htaccess de la raíz de tu sitio:
AddType text/plain; charset=utf-8 .txt
Si el archivo devuelve 404, verifica que no haya una regla RewriteRule que intercepte la petición antes de que Apache sirva el fichero estático. - Nginx: en la mayoría de configuraciones por defecto, Nginx ya mapea la extensión .txt a text/plain en su archivo mime.types. Si aun así el tipo MIME no es el correcto, añade un bloque de localización explícito en tu configuración:
location = /llms.txt { types { text/plain txt; } } - WordPress (Apache): en WordPress con Apache, el archivo estático en la raíz se sirve directamente sin pasar por PHP, siempre que el fichero exista en disco. La condición RewriteCond %{REQUEST_FILENAME} !-f del .htaccess de WordPress excluye los archivos reales del rewrite. Si ves text/html, añade la directiva AddType indicada arriba. Si usas un plugin de caché que intercepta todas las rutas, revisa su configuración de exclusiones.
- Webflow: Webflow permite subir el archivo llms.txt directamente desde los ajustes de SEO sin necesidad de gestionar redirecciones ni tipos MIME manualmente.
Error 3: ¿Tu Markdown está bien formado?
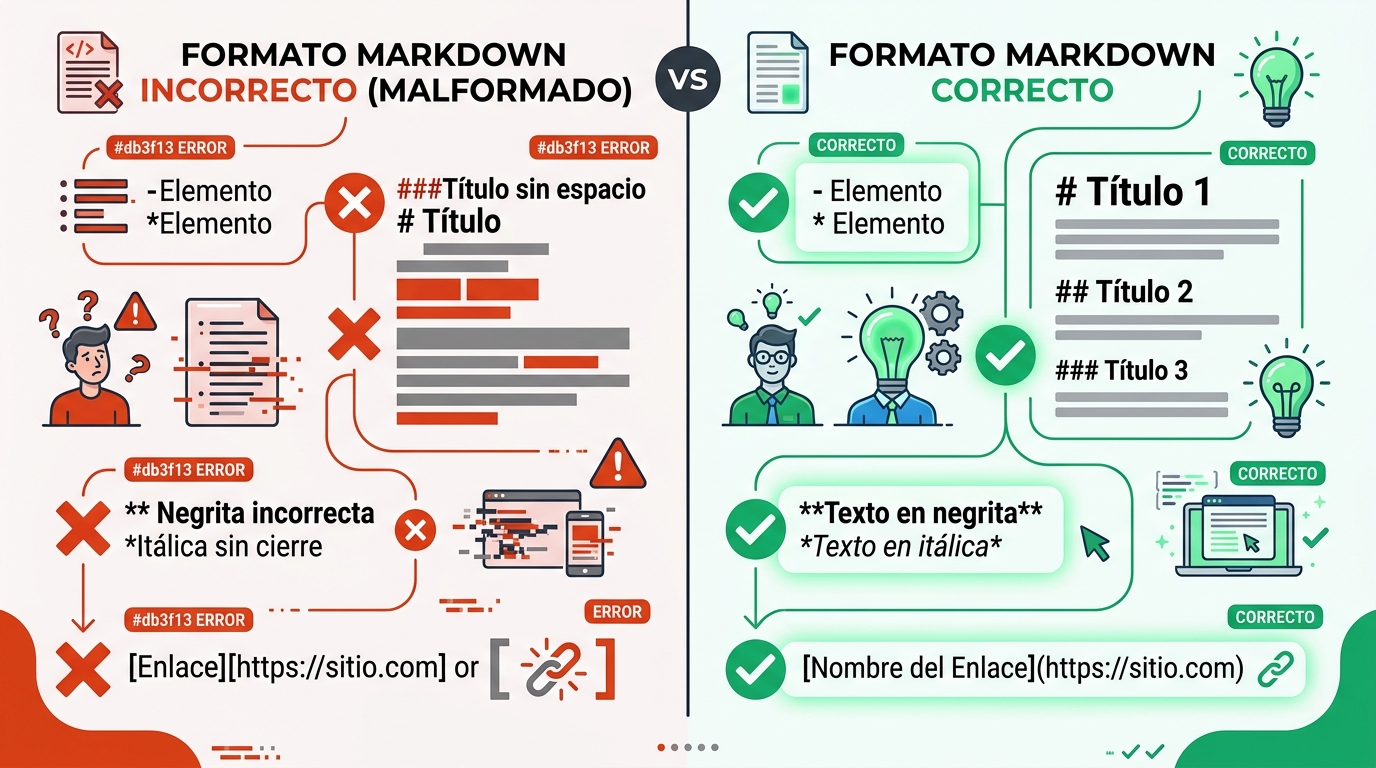
El formato Markdown de llms.txt no es libre: tiene una estructura definida por la especificación publicada en llmstxt.org. El error más básico es empezar el archivo sin un encabezado H1 o usar la sintaxis incorrecta. El archivo siempre debe comenzar con exactamente un # seguido del nombre del sitio. Un fichero mal estructurado es, en la práctica, tan inútil como uno ausente.
Errores de sintaxis frecuentes (con ejemplos antes/después)
La mayoría de los fallos reales no son archivos inexistentes, sino errores de formato en el propio llms.txt. El más común es escribir los enlaces como texto plano en lugar de usar la sintaxis Markdown correcta. Este tipo de error pasa desapercibido visualmente pero rompe el parseo por completo.
❌ Incorrecto — enlace como texto plano:
## Servicios
Consultoría SEO: https://tudominio.com/servicios/seo
Auditoría web: https://tudominio.com/servicios/auditoria
✅ Correcto — sintaxis Markdown con descripción:
## Servicios
– [Consultoría SEO](https://tudominio.com/servicios/seo): Servicio de posicionamiento orgánico para empresas B2B.
– [Auditoría web](https://tudominio.com/servicios/auditoria): Análisis técnico y de contenido con informe de recomendaciones.
Usar rutas relativas en lugar de URLs completas es otro fallo frecuente en los ficheros llms.txt. Siempre deben usarse URLs absolutas que empiecen por https://.
❌ Incorrecto — ruta relativa:
– [Sobre nosotros](/sobre-nosotros): Quiénes somos y cómo trabajamos.
✅ Correcto — URL absoluta:
– [Sobre nosotros](https://tudominio.com/sobre-nosotros): Quiénes somos y cómo trabajamos.
Lo que no está permitido en el cuerpo del archivo: imágenes, HTML, tablas, bloques de código, H1 adicionales o encabezados anidados dentro de las secciones de enlaces. Los parsers esperan texto Markdown y listas de enlaces. Cuanto más simple, más fiable es la lectura.
El problema de los múltiples H1
No tener H1 invalida el archivo directamente, ya que es el único elemento obligatorio según la especificación. Pero tener varios H1 es igualmente un error en llms.txt: la especificación exige exactamente uno. Para las secciones internas, se usan H2.
❌ Incorrecto — dos H1:
# Mi empresa
# Servicios principales
– [Consultoría](https://tudominio.com/servicios): Descripción.
✅ Correcto — un H1, secciones en H2:
# Mi empresa
> Agencia de marketing especializada en empresas B2B del sector tecnológico en España.
## Servicios principales
– [Consultoría](https://tudominio.com/servicios): Descripción.
Un archivo con dos líneas que empiecen por # es un llms.txt roto, aunque visualmente parezca bien estructurado.
Error 4: ¿Hay conflicto entre robots.txt y llms.txt?
Esta contradicción es más habitual de lo que parece, especialmente en sitios que han ido creciendo sin una estrategia clara. Algunos sitios usan directivas de robots.txt o cabeceras X-Robots-Tag para bloquear agentes de IA, y luego listan esas mismas páginas en llms.txt. El resultado es un conflicto que el modelo no puede resolver: le dices que existe ese contenido pero le prohíbes acceder a él. Este tipo de incoherencia entre robots.txt y el fichero es uno de los errores que más cuesta detectar sin una auditoría específica.
La regla práctica es sencilla: cualquier URL que incluyas en llms.txt debe ser accesible públicamente, sin autenticación y sin estar bloqueada para rastreadores de IA en robots.txt. Bloquear el propio archivo llms.txt en robots.txt es otro error frecuente que anula por completo su utilidad.
Error 5: ¿Tu archivo tiene información desactualizada o secciones vacías?
Un llms.txt con nombres de producto obsoletos, precios antiguos o servicios descontinuados es peor que no tener ningún archivo: si un sistema de IA evalúa el fichero, transmitirá información incorrecta. La solución es actualizar el archivo con cada cambio relevante.
El segundo error más común es publicar el fichero y no volver a tocarlo. Un llms.txt desactualizado que apunta a páginas de precios antiguas, documentación obsoleta o URLs muertas es más perjudicial que no tener ninguno. Mantener al día el contenido del archivo es tan importante como tenerlo bien configurado técnicamente.
Las secciones vacías —un encabezado H2 sin ningún enlace o descripción debajo— son igualmente problemáticas en cualquier llms.txt. Le dicen al modelo que esa categoría existe, pero no le dan nada con lo que trabajar. Si una sección no tiene contenido que añadir, elimínala del archivo.
Error 6: ¿Has olvidado el contexto de negocio?
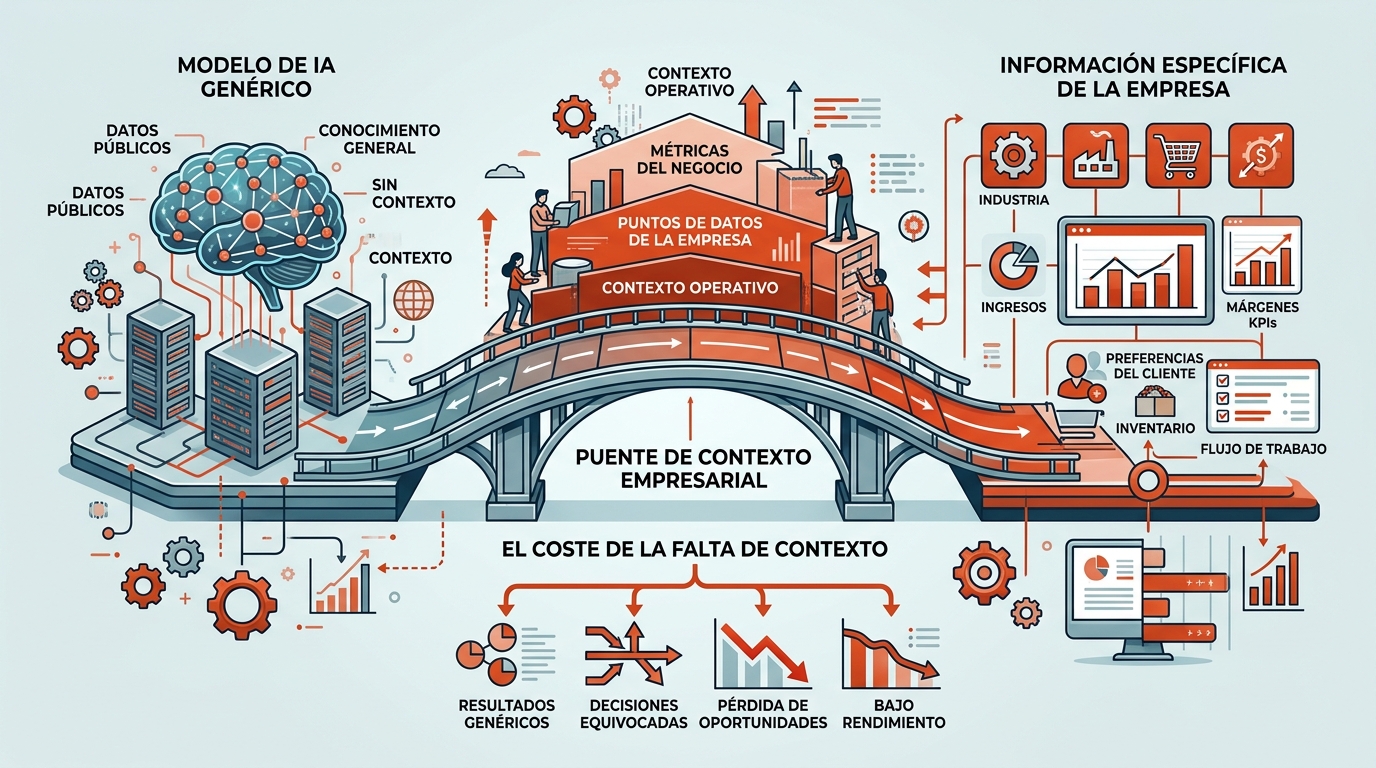
Técnicamente, el archivo está bien: ruta correcta, Markdown válido, URLs accesibles. Pero le falta lo más valioso: el contexto que le dice a la IA quién eres, a quién sirves y cómo ayudas a tus clientes. Es el error de contenido que más vemos al auditar archivos llms.txt de clientes.
La mayoría de los ficheros que revisamos son listas de URLs sin más. No incluyen a qué público va dirigido el negocio, en qué zona geográfica opera, qué problema resuelve o cuál es su propuesta de valor diferencial. Esa información es exactamente la que un modelo de IA necesita para citarte como fuente relevante cuando alguien hace una pregunta relacionada con tu sector. Sin ese contexto —sin esas señales de contexto para LLMs—, el llms.txt apenas aporta más señal que el propio sitemap.
La diferencia entre una descripción que funciona y una que no se ve muy claramente con un ejemplo:
❌ Descripción vaga (no aporta contexto real):
> Somos una empresa innovadora que desarrolla soluciones digitales para nuestros clientes.
✅ Descripción concreta y diferenciadora:
> Agencia de ingeniería de marketing especializada en empresas B2B del sector tecnológico en España. Ayudamos a equipos de marketing a construir sistemas de contenido que generan demanda cualificada, con foco en SEO técnico, arquitectura de contenido y visibilidad ante modelos de IA.
La primera descripción podría aplicarse a miles de sitios. La segunda le dice al modelo exactamente quién eres, para quién trabajas, dónde operas y qué resultado produces. Un llms.txt sin esa concreción desperdicia su mayor ventaja frente a otros formatos de señal para IA.
Error 7: ¿Lo generaste a mano y lo abandonaste a las semanas?
Es el error que vemos con más frecuencia cuando una empresa nos pide ayuda para configurar su llms.txt. Generar el fichero manualmente tiene un coste de tiempo y esfuerzo que, en la práctica, hace que se abandone a las pocas semanas de iniciarlo. El archivo queda desactualizado y pasa de ser un activo a un lastre.
La solución que aplicamos nosotros mismos es usar una herramienta que automatice la generación y el mantenimiento del llms.txt. En nuestro caso, trabajamos con getllmsready.com, que permite generar un archivo conforme a la especificación sin tener que editar Markdown a mano. Después de los primeros meses, comprobamos que los ajustes más importantes no eran técnicos, sino de contenido: habíamos dejado fuera información de negocio que los modelos de IA necesitan para contextualizar correctamente quiénes somos.
La clave no es crear el archivo una vez: es mantenerlo vivo. Cada vez que lances un servicio nuevo, cambies tu propuesta de valor o actualices una página importante, el llms.txt debe reflejarlo. Una herramienta que automatice ese proceso es la diferencia entre un activo que trabaja para ti y un fichero olvidado en la raíz del servidor.
¿Necesitas también un llms-full.txt?
La especificación oficial de llmstxt.org define llms.txt como un índice ligero de páginas clave. Junto a él ha surgido una convención complementaria —llms-full.txt— que no forma parte del estándar original pero que algunos sitios publican como extensión práctica.
Según un análisis detallado de la especificación, llms-full.txt no está definido en llmstxt.org: es una convención popularizada principalmente por plataformas de documentación como Mintlify, que concatena el contenido completo del sitio en un único archivo Markdown para que un modelo pueda ingerirlo en un solo paso sin rastrear cada URL individualmente.
La distinción práctica es clara: llms.txt es un mapa; llms-full.txt es el territorio completo. El primero tiene un peso de tokens reducido (generalmente menos de 5.000 tokens para la mayoría de sitios); el segundo puede alcanzar decenas de megabytes, lo que supera con creces la ventana de contexto de cualquier modelo actual.
¿Cuándo conviene publicar llms-full.txt? La respuesta depende del tipo de sitio:
- Sitios de marketing, blogs y páginas corporativas: llms.txt es suficiente. Añadir llms-full.txt no aporta ventaja significativa y complica el mantenimiento.
- Documentación técnica, bases de conocimiento y SaaS con muchas páginas de docs: investigación de Profound sobre rastreo de IA indica que los bots de Microsoft y OpenAI acceden con más frecuencia a llms-full.txt que al propio llms.txt, probablemente porque el archivo con contenido completo elimina un paso de recuperación para los agentes.
- Sistemas RAG internos: llms-full.txt puede ser útil para alimentar pipelines de recuperación aumentada, aunque en ese contexto suele gestionarse de forma privada, no como archivo público.
Si decides publicar llms-full.txt, mantenlo por debajo de 50.000 tokens para que sea procesable. Un archivo de 56 MB como el de Cloudflare es técnicamente válido pero difícilmente ingerible por ningún modelo en producción. Y, como con llms.txt, la actualización automática es imprescindible: un llms-full.txt desactualizado multiplica el daño porque propaga información incorrecta a mayor escala.
Ejemplo de llms.txt completo y funcional
Los ejemplos parciales ayudan a entender cada error por separado, pero lo más útil es ver cómo queda un archivo completo que aplica todas las buenas prácticas. El siguiente ejemplo integra los elementos que la especificación exige y los que más impacto tienen en la visibilidad ante modelos de IA: H1 único, descripción de negocio concreta, secciones H2 con URLs absolutas y descripciones, y una sección Optional para contenido secundario.
✅ Ejemplo de llms.txt completo y correcto:
# Amara, ingeniería de marketing
> Agencia especializada en marketing B2B para empresas tecnológicas en España. Ayudamos a equipos de marketing a construir sistemas de contenido que generan demanda cualificada, con foco en SEO técnico, arquitectura de contenido y visibilidad ante modelos de IA.
## Servicios
– [SEO técnico y auditoría web](https://amara-marketing.com/servicios/seo-tecnico/): Análisis y corrección de problemas técnicos que limitan el posicionamiento orgánico.
– [Arquitectura de contenido](https://amara-marketing.com/servicios/arquitectura-contenido/): Diseño de estructuras de contenido orientadas a capturar demanda en buscadores y motores generativos.
– [Visibilidad en IA](https://amara-marketing.com/servicios/visibilidad-ia/): Optimización de señales de contexto para que los modelos de lenguaje citen y recomienden tu marca.
## Contenido de referencia
– [Qué es llms.txt y por qué deberías tenerlo](https://amara-marketing.com/estructura-web-y-seo/llms-txt/): Guía completa sobre el estándar, su especificación y cómo implementarlo correctamente.
– [Errores en llms.txt que arruinan tu visibilidad ante la IA](https://amara-marketing.com/estructura-web-y-seo/errores-llms-txt/): Los fallos técnicos y de contenido más comunes y cómo corregirlos.
– [Cluster SEO para empresas B2B](https://amara-marketing.com/blog/cluster-seo-b2b/): Metodología para construir autoridad temática en nichos competitivos.
## Sobre nosotros
– [Quiénes somos](https://amara-marketing.com/sobre-nosotros/): Equipo, metodología y enfoque de trabajo de Amara, ingeniería de marketing.
– [Casos de éxito](https://amara-marketing.com/casos/): Resultados reales de clientes en sectores tecnológicos y de servicios B2B.
## Optional
– [Blog](https://amara-marketing.com/blog/): Artículos sobre SEO técnico, contenido y estrategia de marketing digital.
– [Contacto](https://amara-marketing.com/contacto/): Formulario para solicitar una auditoría o una primera consulta.
Fíjate en los detalles que hacen que este archivo funcione: la descripción en el bloque de cita responde a quién sirve el negocio, dónde opera y qué resultado produce; cada enlace tiene una descripción que aporta contexto real, no solo el nombre de la página; la sección Optional agrupa el contenido menos crítico para que los modelos con contexto limitado puedan omitirla; y no hay ningún elemento prohibido —ni tablas, ni imágenes, ni HTML incrustado—. Este es el estándar mínimo que debería cumplir cualquier llms.txt antes de darse por válido.
Herramientas para validar tu llms.txt
Antes de dar por bueno el archivo, pásalo por un validador. La comprobación manual tiene puntos ciegos; un validador automatizado detecta errores de sintaxis, tipos MIME incorrectos y URLs rotas en segundos. La elección de herramienta depende del tipo de problema que quieras detectar:
- llmstxtvalidator.dev: el punto de partida recomendado para cualquier auditoría de llms.txt. Comprueba la estructura Markdown, el H1 único, la sintaxis de los enlaces y la accesibilidad de las URLs. Úsalo primero, antes de cualquier otra herramienta, para descartar errores de especificación.
- curl -I tudominio.com/llms.txt: el comando más rápido para verificar el tipo MIME y el código de respuesta HTTP directamente desde tu terminal. Si el Content-Type no es text/plain; charset=utf-8, tienes un problema de servidor que ningún validador de contenido puede resolver por ti. Úsalo siempre después de cualquier cambio en la configuración del servidor.
- Revisión manual de URLs: ningún validador sustituye a comprobar que cada URL listada devuelve un código 200 y apunta al contenido correcto. Hazlo al menos una vez al trimestre, especialmente si tu sitio cambia con frecuencia. Es el único método que detecta redirecciones silenciosas o páginas que devuelven 200 pero muestran contenido genérico.
La especificación oficial vive en llmstxt.org y fue propuesta por Jeremy Howard en septiembre de 2024. Enlaza siempre a esa fuente cuando cites la especificación: da autoridad a tu argumento y facilita que el lector contraste la información.
Checklist para revisar tu llms.txt ahora mismo
Antes de dar por válido tu archivo, recorre esta lista. Si algún punto falla, corrígelo antes de continuar con el siguiente: los errores técnicos básicos invalidan todo lo demás.
Ver los datos
- Comprueba que el archivo está en https://tudominio.com/llms.txt sin redirecciones ni errores
- Verifica que el servidor devuelve Content-Type: text/plain; charset=utf-8 (Usa curl -I tudominio.com/llms.txt)
- Guarda el archivo como UTF-8 sin BOM
- Asegúrate de que hay exactamente un encabezado H1 con el nombre del sitio
- Usa la sintaxis [texto](https://url-completa) en todos los enlaces (Sin texto plano ni rutas relativas)
- Elimina tablas, imágenes, bloques de código y HTML incrustado
- Revisa que ninguna URL listada esté bloqueada en robots.txt (Incluido el propio /llms.txt)
- Añade al menos un enlace con descripción bajo cada H2
- Incluye en la descripción inicial quién eres, a quién sirves y qué problema resuelves
- Confirma que todas las URLs devuelven código 200
- Ruta correcta: el archivo está en https://tudominio.com/llms.txt y carga sin redirecciones ni errores.
- Tipo MIME: el servidor devuelve Content-Type: text/plain; charset=utf-8 (compruébalo con curl -I). Si no, aplica la corrección correspondiente a tu entorno (Apache, Nginx o WordPress).
- Codificación UTF-8: el archivo está guardado como UTF-8 sin BOM; los caracteres especiales se muestran correctamente.
- Un único H1: el archivo empieza con exactamente un encabezado # con el nombre del sitio o la marca.
- Sintaxis Markdown válida: todos los enlaces usan el formato [texto](https://url-completa), no texto plano ni rutas relativas.
- Sin HTML ni elementos prohibidos: no hay tablas, imágenes, bloques de código ni HTML incrustado.
- Sin conflictos con robots.txt: ninguna URL listada en llms.txt está bloqueada para rastreadores de IA; el propio /llms.txt tampoco está bloqueado.
- Sin secciones vacías: cada H2 tiene al menos un enlace con descripción debajo.
- Información de negocio presente: la descripción inicial responde a quién eres, a quién sirves, dónde operas y qué problema concreto resuelves.
- URLs activas: todas las URLs del archivo devuelven código 200 y no están redirigidas a páginas genéricas.
- Fecha de última actualización: el archivo refleja el estado actual del sitio; si hay servicios o páginas nuevas, están incluidos.
- Herramienta o proceso de mantenimiento: tienes definido cómo y cuándo actualizarás el archivo cuando cambie algo relevante.
Con esta checklist puedes auditar tu llms.txt en menos de diez minutos. Lo habitual es que los errores técnicos estén resueltos pero los de contenido —especialmente el contexto de negocio— sigan pendientes. Son los que más impactan en la visibilidad en respuestas generativas y los que más se pasan por alto.
Preguntas frecuentes sobre los errores en llms.txt
¿Cómo sé si mi llms.txt está siendo leído por los modelos de IA?
No existe un panel de control oficial que confirme que un modelo concreto ha leído tu archivo. Lo que sí puedes hacer es verificar que el fichero es técnicamente válido usando un validador como el de llmstxtvalidator.dev, comprobar que la URL carga correctamente y que el tipo MIME es el adecuado. Si el llms.txt supera esas comprobaciones, está en condiciones de ser procesado por los sistemas que lo soporten.
¿Es peor tener un llms.txt mal configurado que no tener ninguno?
En algunos casos, sí. Un archivo con información desactualizada —precios incorrectos, servicios que ya no existen, URLs rotas— puede hacer que un modelo de IA transmita datos erróneos sobre tu negocio. Si no tienes tiempo de mantenerlo, es mejor no publicarlo hasta que puedas hacerlo bien. Lo óptimo es usar una herramienta que automatice la generación y el mantenimiento.
¿Qué pasa si bloqueo llms.txt en mi robots.txt?
El archivo queda inaccesible para los rastreadores que respetan robots.txt, lo que anula completamente su utilidad. Es un error más frecuente de lo que parece, especialmente cuando se aplican reglas de bloqueo masivo de bots sin revisar qué rutas específicas se están bloqueando. Comprueba que /llms.txt no aparece en ninguna directiva Disallow de tu robots.txt.
¿Con qué frecuencia debo actualizar mi llms.txt?
Como mínimo, cada vez que haya un cambio relevante en tu sitio: un servicio nuevo, una página importante actualizada, un cambio en tu propuesta de valor o en tu público objetivo. Si usas una herramienta de generación automática, el proceso es mucho más sencillo. Como referencia, en Amara revisamos el archivo cada vez que publicamos contenido nuevo de peso o cuando hay cambios en la oferta de servicios.
¿Debo incluir todas las páginas de mi sitio en llms.txt?
No. La especificación asume curación, no exhaustividad. Incluir cientos de URLs sin criterio reduce la señal de relevancia del archivo. Lo recomendable es seleccionar las páginas que mejor representan tu negocio: servicios principales, páginas de quiénes somos, contenido de referencia y preguntas frecuentes. Si todo es prioritario, nada lo es.